
Agentic AI w NetOps
 Sif Baksh
Cisco i Omdia opublikowały raport The Impact of Agentic AI on Network Operations — i jedna liczba zasługuje na uwagę: 51% ankietowanych organizacji już dziś uruchamia agentów AI, którzy podejmują działania w produkcji, a nie tylko rekomendują.
Kierunek jest wyraźny. Pytanie przestaje brzmieć „czy AI może pomóc inżynierowi sieci?" — zaczyna brzmieć „co jesteśmy gotowi pozwolić AI robić?"
Większość teamów NetOps ma już Python, Ansible, Nornir, NetBox, monitoring i observability. Wiemy, jak wysłać komendę i wypchnąć konfigurację.
92% respondentów raportu przyznaje, że incydenty regularnie obejmują wiele domen, a do uzyskania pełnej widoczności używają średnio 10 osobnych narzędzi.
To jest właściwy problem. Użytkownik zgłasza, że aplikacja działa wolno — i zaczyna się: monitoring, interfejsy, routing, DNS, firewall, last changes, telemetria aplikacji, cloud, source of truth. Trzy zakładki w przeglądarce, dwa terminale, ticket i Slack jednocześnie.
Żaden z tych kroków nie jest trudny. Łączenie dowodów — to jest właściwa praca. I dokładnie tutaj agent ma sens.
Popularne jest teraz wstawianie agenta przed wszystko, bo to modne. To błąd.
Jeśli workflow jest znany i deterministyczny — zostaw go deterministyczną automatyzacją. Agent staje się wartościowy, gdy następny krok zależy od dowodów zebranych w poprzednim. Klasyczny przykład: troubleshooting BGP.
Agent sprawdza stan BGP → widzi resety → bada interfejs → wykrywa błędy CRC → sprawdza ostatnie zmiany → nie ma zmian → sięga po statystyki transceivera. Ścieżka zmienia się dynamicznie wraz z napływającymi danymi.
Preferowana architektura:
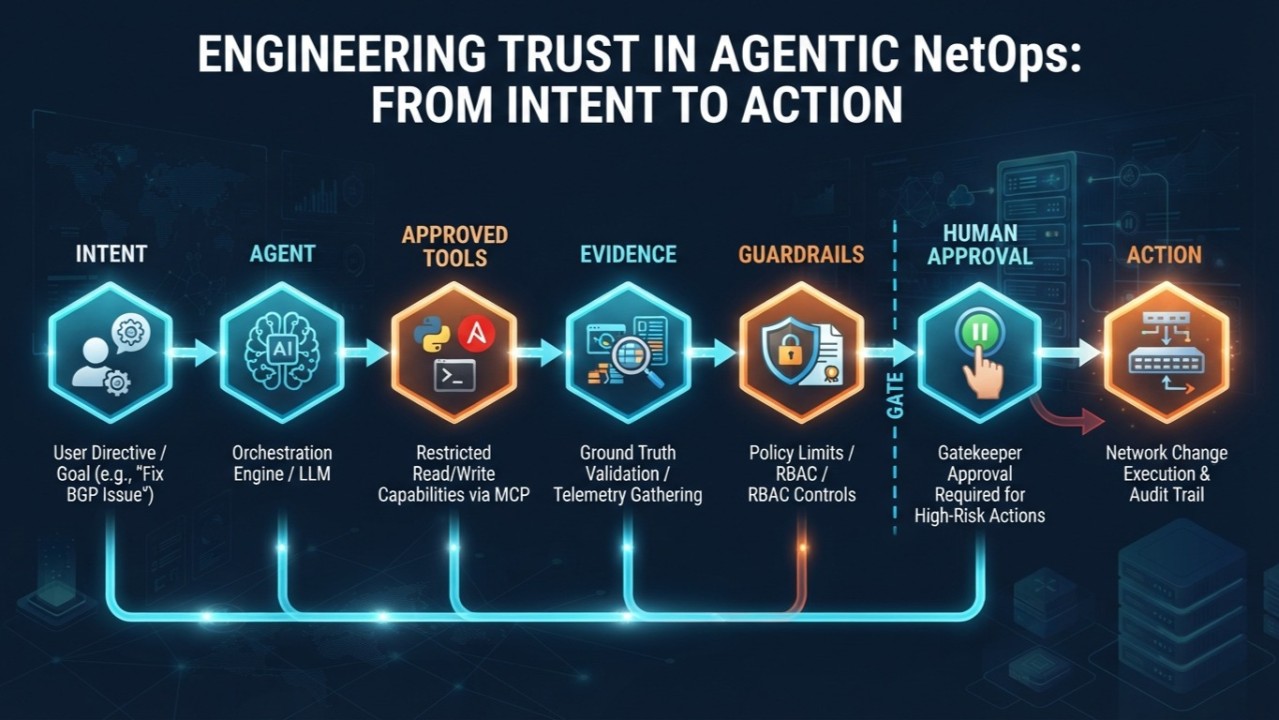
Intent → Agent → Approved Tools → Evidence
→ Decision → Policy + Guardrails
→ Human Approval (gdy wymagane) → Action → Validation
LLM to jeden element tego systemu. Kłopoty zaczynają się, gdy zaczynamy traktować go jako cały system.
80% respondentów raportu deklaruje komfort z wysoką autonomią AI w NetOps. Jednocześnie 56% wymaga zgody człowieka przy działaniach. To nie jest sprzeczność — to dojrzałe podejście.
Nie każda akcja niesie to samo ryzyko. Agent może samodzielnie odpytywać liczniki interfejsów, sprawdzać stan BGP, analizować logi, korelować telemetrię — i nikomu to nie przeszkadza. Zmiana polityki routingu na core routerze to zupełnie inna rozmowa.
Zanim jednak zwiększysz autonomię agenta, sprawdź jego dowody, nie tylko wnioski. LLM potrafi wygenerować przekonujące wyjaśnienie dla zupełnie błędnej konkluzji. Explainability bez audytu dowodów nie rozwiązuje tego problemu.
Użyteczny raport z dochodzenia wygląda tak:
- Obserwacja: BGP neighbor 10.10.10.2 resetował się 7 razy w ciągu 12 minut
- Dowód: Ethernet1/1 odnotował 2843 błędy CRC w tym samym oknie
- Hipoteza: Niestabilność warstwy fizycznej jako prawdopodobna przyczyna
- Rekomendacja: Sprawdź transceiver przed dotykaniem konfiguracji BGP
To jest coś, co inżynier może zweryfikować, zakwestionować i zatwierdzić.
Dlaczego 4x10G to nie to samo co 40G?
 Tony Mattke
Standard 802.3ad (dziś 802.1AX) mówi jedno twardo: ramki jednej "konwersacji" nie mogą być reorderowane. Jedyny sposób, by to zagwarantować, to przypięcie każdego flow do dokładnie jednego membera na stałe. Żaden vendor nie stripuje pojedynczego flow między linkami - to złamałoby regułę kolejności.
Konsekwencja jest prosta: pojedynczy strumień (backup, vMotion, replikacja iSCSI) nigdy nie przekroczy przepustowości jednego membera, niezależnie od tego, ile linków masz w bundlu. 4x10G LAG to 40G agregatu przy wielu równoległych flow, nie 40G dla jednej sesji. Jeśli masz workloady generujące pojedyncze "słoniowe" flow, więcej linków nic nie da - potrzebujesz szybszych linków.
Standard nie narzuca algorytmu dystrybucji ruchu - tylko zakaz reorderingu. Efekt: każdy vendor liczy hash inaczej (MAC, IP, porty L4, różne XOR), domyślne ustawienia różnią się między platformami i generacjami IOS/NX-OS, a nawet dwa końce tego samego bundla mogą hashować inaczej - LACP negocjuje membership, nigdy dystrybucję.
Na starszym Catalyst hardware hash redukuje się do 3-bitowej wartości (0-7), rozdzielanej między membery. To dlatego bundle działają najlepiej w potęgach dwójki - przy 3 członkach dwa dostają po 37,5% ruchu, trzeci tylko 25%, zanim realny ruch w ogóle wejdzie do gry.
Polaryzacja w architekturze wielowarstwowej
Gdy stackujesz bundle access-distribution-core i każda warstwa liczy hash tym samym algorytmem na tych samych polach, flow trafiający w bucket 0 na dole trafi w bucket 0 też wyżej - na każdym poziomie. Zamiast rozkładać ruch, cała topologia koncentruje go na tym samym podzbiorze linków, a reszta "redundantnej" przepustowości stoi bezczynnie.
Lekarstwo: różnicować pola hashujące między warstwami (np. src-dst-IP niżej, dodać L4 porty wyżej) oraz hardware'owe triki typu per-device seed. Ten sam problem dotyka ECMP w fabrykach Clos i jest jeszcze bardziej palący w fabrykach AI, gdzie pojedyncze flow GPU-to-GPU potrafią zapchać cały uplink.
Co z tym zrobić dziś: jeśli planujesz LAG pod duże pojedyncze strumienie (backup, storage, AI), nie licz przepustowości agregatu - licz przepustowość pojedynczego membera. Sprawdź też, jakich pól używa hash na Twojej platformie (show etherchannel load-balance na Cisco) i czy warstwy w topologii nie hashują identycznie.
Awesome Nokia
 Andy Whitaker & Nokia Community
Serwis zawiera katalog 66 narzędzi i projektów związanych z ekosystemem Nokia oraz automatyzacją sieci. Znajdziesz tu m.in. rozwiązania do tworzenia laboratoriów sieciowych w Containerlab, systemy SR Linux i SROS, narzędzia EDA oraz NSP, a także biblioteki do automatyzacji, monitorowania i zbierania danych telemetrycznych. To dobre miejsce, jeśli pracujesz z infrastrukturą sieciową, szukasz narzędzi NetDevOps albo chcesz poznać projekty rozwijane przez społeczność skupioną wokół technologii Nokia.
Agenci i SONiC
 mairp
Projekt pokazuje sterowanie siecią SONiC EVPN/VXLAN za pomocą poleceń w języku naturalnym. Agenci tworzą obiekty Kubernetes, kontrolery wdrażają je w topologii i weryfikują konfigurację. System obsługuje m.in. VLAN-y, mac-VRF, ip-VRF i ACL-e, monitoruje stan, naprawia rozbieżności oraz wycofuje nieudane zmiany. Środowisko obejmuje dwa spine’y, dwa leafy, klientów i monitoring Prometheus/Grafana. Obsługa bram IPv6 IRB jest ograniczona, a część obrazów wymaga pobrania z rejestru.
SRv6 w praktyce
Przeczytaj całą historię
Zarejestruj się teraz, aby przeczytać całą historię i uzyskać dostęp do wszystkich postów za tylko dla płacących subskrybentów.
Subskrybuj